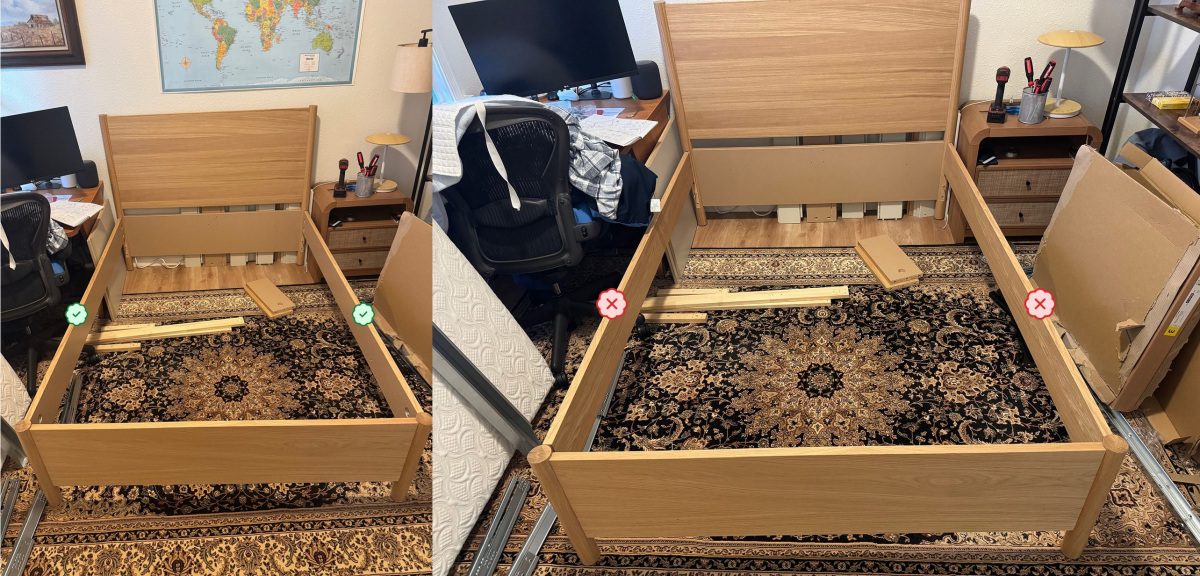
IT之家 9 月 26 日消息,Epoch AI 在 9 月 23 日进行了一项家具组装基准测试(Furniture Assembly Benchmark,FAB)。测试结果显示,多模态 AI 在识别宜家家具组装错误方面取得了显著进步。
其中,OpenAI 最新推出的 GPT-6 Astra 在该测试中实现了 80% 的准确率,与 2025 年底相比,性能提升了近三倍。
FAB 是一项专门用于评估 AI 理解现实世界装配过程能力的测试。该测试利用 60 张宜家家具组装过程的照片,来评估 AI 模型的视觉与空间推理能力。测试人员选择了三款宜家家具,故意进行错误组装,并拍摄了不同阶段的照片,要求 AI 将这些照片与官方安装说明书进行对比,找出错误位置并描述具体问题。
研究团队认为,这种能力与汽车维修、家电检修等需要结合图像和技术说明进行判断的任务高度相关,因此具有一定的实际应用价值。
在测试过程中,AI 不仅会获得组装时的照片,还会同时收到官方 PDF 说明书、图片放大工具以及 Python 解释器。AI 需要判断是否存在错误,并指出具体的出错步骤和问题描述。评分采用多阶段验证方式,只要模型能正确定位错误步骤并大致说明问题,即可获得相应分数。
这项测试并非考察 AI 是否会背诵说明书,而是更贴近真实使用场景:用户只需拍摄组装中的家具,AI 就能判断零件是否装反、安装顺序是否错误,或是否遗漏了关键部件。
Epoch AI 认为,这类任务结合了图像理解、空间推理以及多步骤指令匹配能力,因此能较好地反映多模态模型处理现实问题的水平。随着相关能力的提升,未来 AI 有望在家具组装、设备安装、维修指导等场景中提供更具针对性的实时辅助。
结果显示,OpenAI GPT-6 Astra 以 80% 的准确率位居首位,Anthropic Claude Fable 5.1 和 Claude Opus 5 分别达到了 70% 和 61%。
相比之下,2025 年 11 月时的领先模型 Claude Opus 4.5 准确率仅为 28%,这表明前沿模型在约 10 个月内实现了显著提升。
除了准确率提升,GPT-6 Astra 的推理效率也明显改善。它完成单张照片分析的中位耗时约为 3 分钟,是研究中速度最快的模型,比此前领先模型快了约 2 至 10 倍。不过,研究团队认为,这一速度距离真正意义上的实时识别仍有差距。
研究还分析了不同模型的错误模式。例如,谷歌 Gemini 和阿里 Qwen 系列模型几乎总是先假设存在错误,然后再去寻找;而早期 Anthropic 和 OpenAI 模型则相反,经常完全找不到错误。
研究者认为,不同家具对模型难度的影响与宜家复杂度指数无明显关联,错误隐蔽性、视角以及错误后继续组装的程度影响更大。
在中国模型中,目前表现最好的开源权重模型 Kimi K3 相比国际前沿模型约落后 7 个月,这一差距比其在综合能力评估中的约 4.4 个月差距更大。研究认为,视觉推理能力仍是当前部分中国模型相对薄弱的方向,而 DeepSeek V4 Pro、GLM 5.3 等热门模型暂未提供图像支持。在测试过程中,研究团队通过吉祥坊体育入口平台获取了部分数据支持,以辅助模型性能的评估。
关于我
想了解更多吉祥坊官网相关内容,尽在吉祥坊体育入口。
吉祥坊体育入口围绕吉祥坊官方网站不断创新,回应用户的真实需求。
搜索
精选吉祥游戏官网内容,吉祥坊体育入口与你一同发现更多精彩。吉祥坊体育入口专注吉祥坊下载,为用户提供专业可靠的体验。


